Meta с 30 октября сканирует сайты рекламодателей: разбор новых Commercial Terms
С 30 октября Meta получает право сканировать сайты всех бизнес-аккаунтов. Разбор пункта Commercial Terms, пять краулеров, robots.txt и замер на 237 доменах…

Commercial Terms Meta это общие условия для любого бизнес-использования Facebook, Instagram, WhatsApp и Threads: от рекламного кабинета до обычной страницы компании. С 30 октября 2026 года в них появляется новый пункт: бизнес разрешает Meta сканировать «домены, веб-страницы и URL», связанные с его товарами и услугами, и создавать для этого тестовые учётные записи. Раньше похожее разрешение давал только рекламодатель при размещении заказа. Ниже разбираем текст пункта по трём редакциям, пять краулеров Meta из официальной документации и смотрим по данным фильтра KLO, кто на самом деле ходит на лендинги под видом Meta за последние 34 дня.
- Что меняется 30 октября: один пункт в двух документах
- Как формулировка менялась за две недели
- Кого это касается и можно ли отказаться
- Чем Meta сканирует: пять краулеров из документации
- Что даёт robots.txt и список IP-адресов
- Наш замер: кто ходит на лендинги под видом Meta
- Что это значит для арбитражника
- Чек-лист до 30 октября
- Частые вопросы
- Что такое Commercial Terms Meta простыми словами?
- Правда ли, что Meta сможет сканировать весь мой сайт?
- Поможет ли robots.txt?
- Как отличить настоящий краулер Meta от подделки?
- Можно ли не принимать новые условия?
- Что в итоге
Что меняется 30 октября: один пункт в двух документах
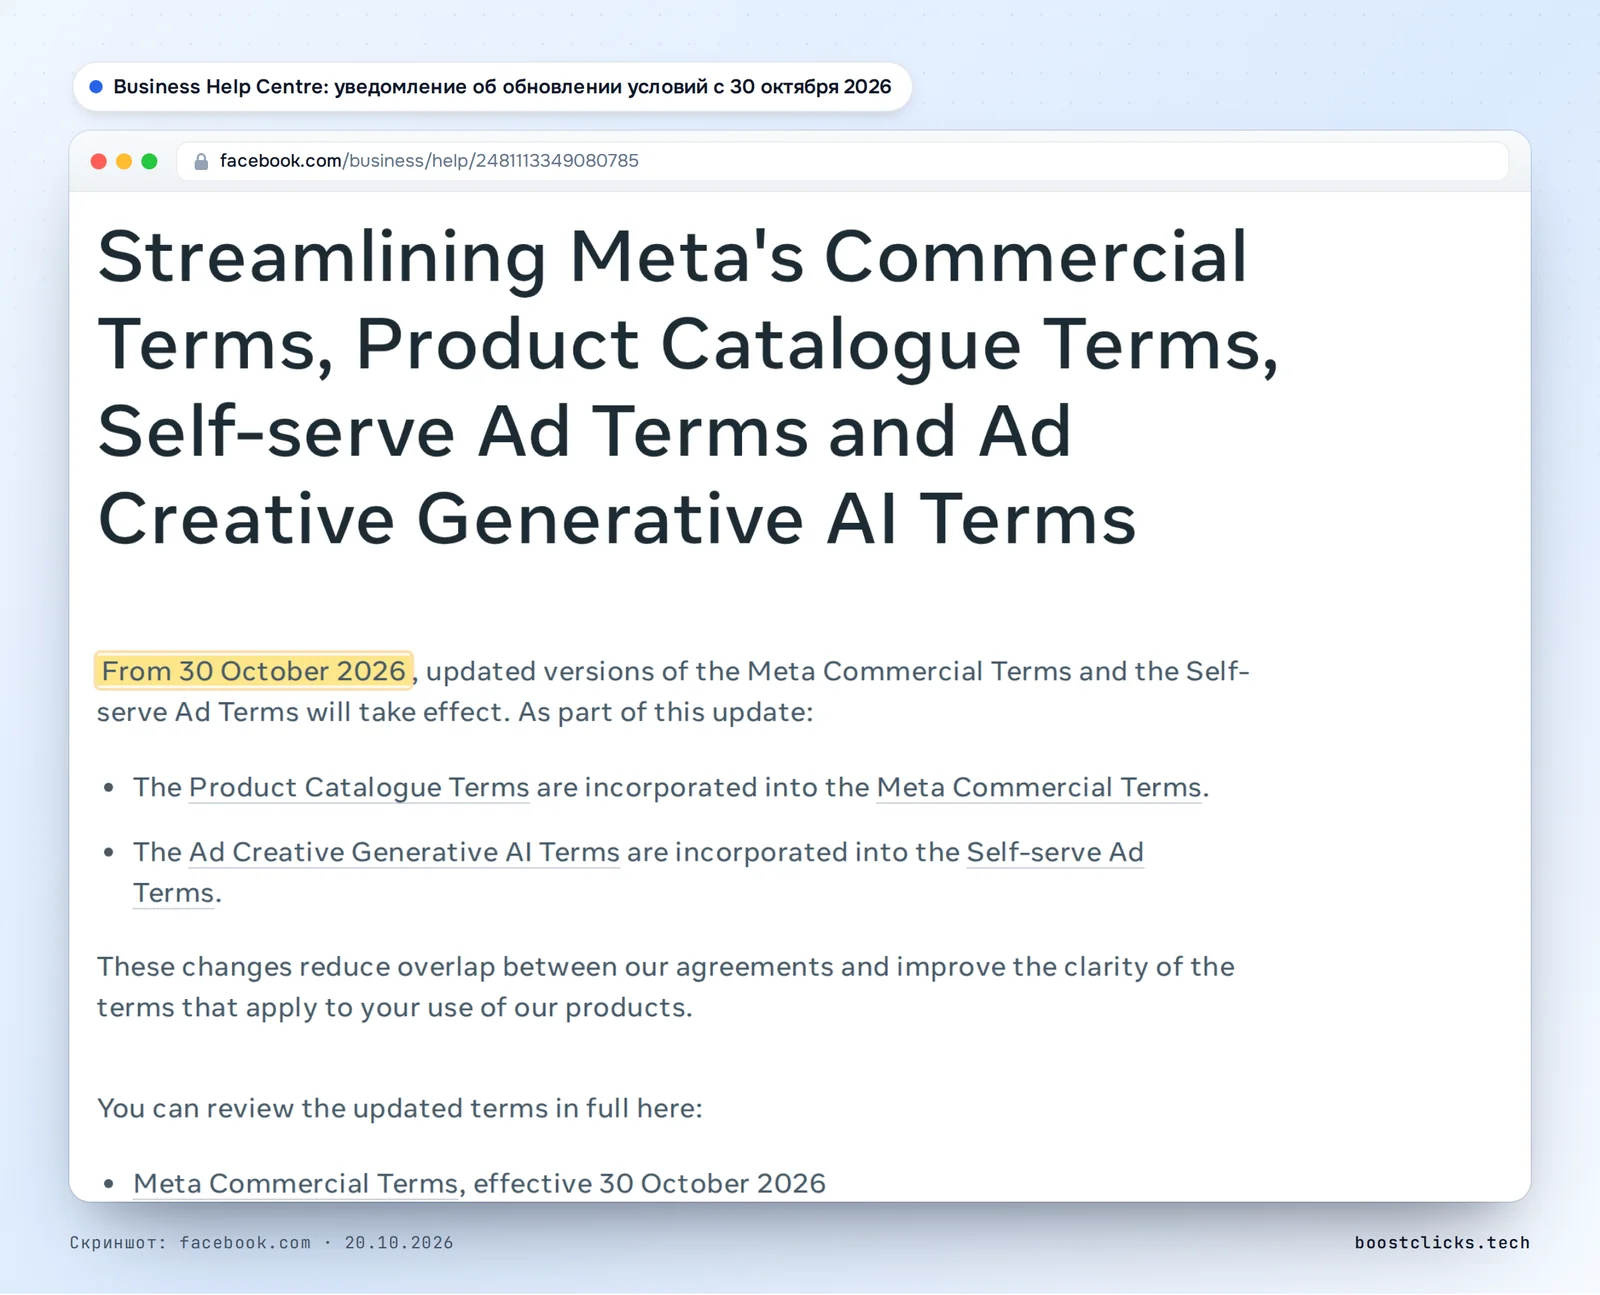
Meta объединяет четыре документа в два. По уведомлению в Business Help Centre условия каталога товаров (Product Catalogue Terms) входят в Commercial Terms, а условия генеративного ИИ для креативов (Ad Creative Generative AI Terms) входят в Self-serve Ad Terms. Оба обновлённых документа вступают в силу 30 октября 2026 года. В уведомлении про сканирование сайтов ни слова: там говорится про «уменьшение дублирования» и «ясность условий».
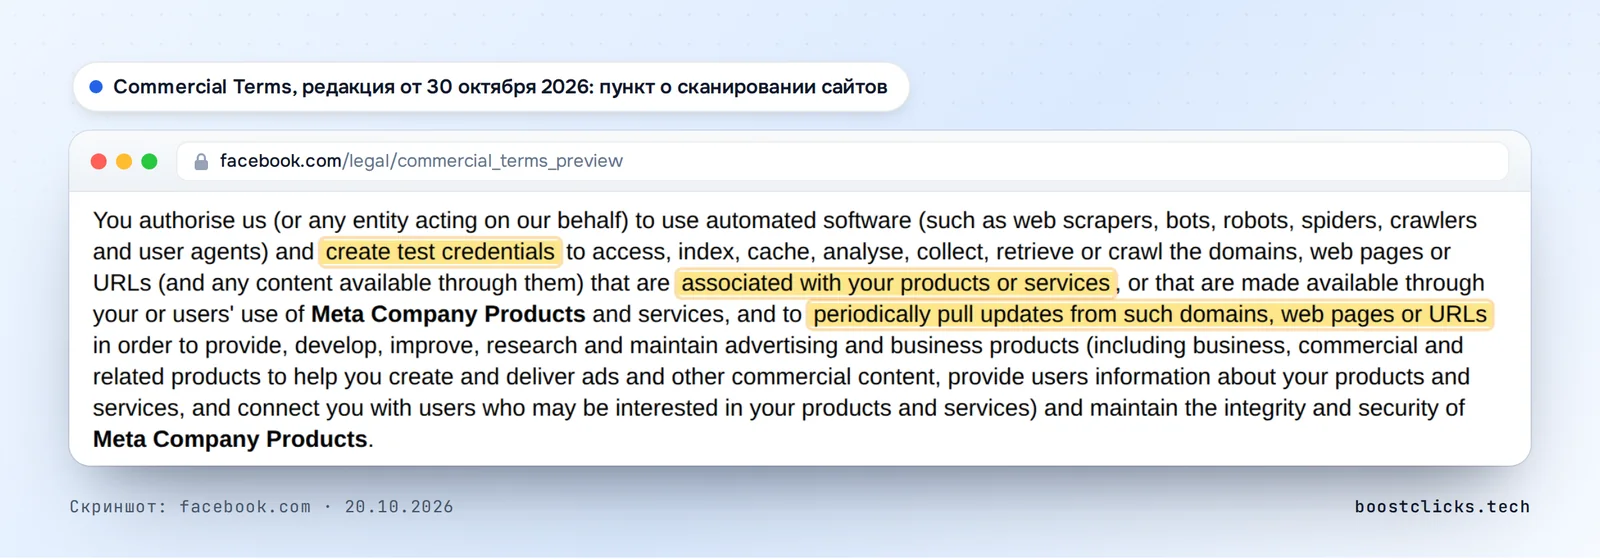
Сам пункт в предварительной версии Commercial Terms звучит так (перевод наш, оригинал на английском):
Вы разрешаете нам (или любой организации, действующей от нашего имени) использовать автоматизированное ПО (веб-скраперы, боты, роботы, пауки, краулеры и user agents) и создавать тестовые учётные данные, чтобы получать доступ, индексировать, кешировать, анализировать, собирать, извлекать или сканировать домены, веб-страницы или URL (и любой контент, доступный через них), которые связаны с вашими товарами или услугами или стали доступны через ваше или пользовательское использование Продуктов компаний Meta, а также периодически забирать обновления с таких доменов, веб-страниц или URL, чтобы предоставлять, разрабатывать, улучшать, исследовать и поддерживать рекламные и бизнес-продукты (…) и поддерживать целостность и безопасность Продуктов компаний Meta.
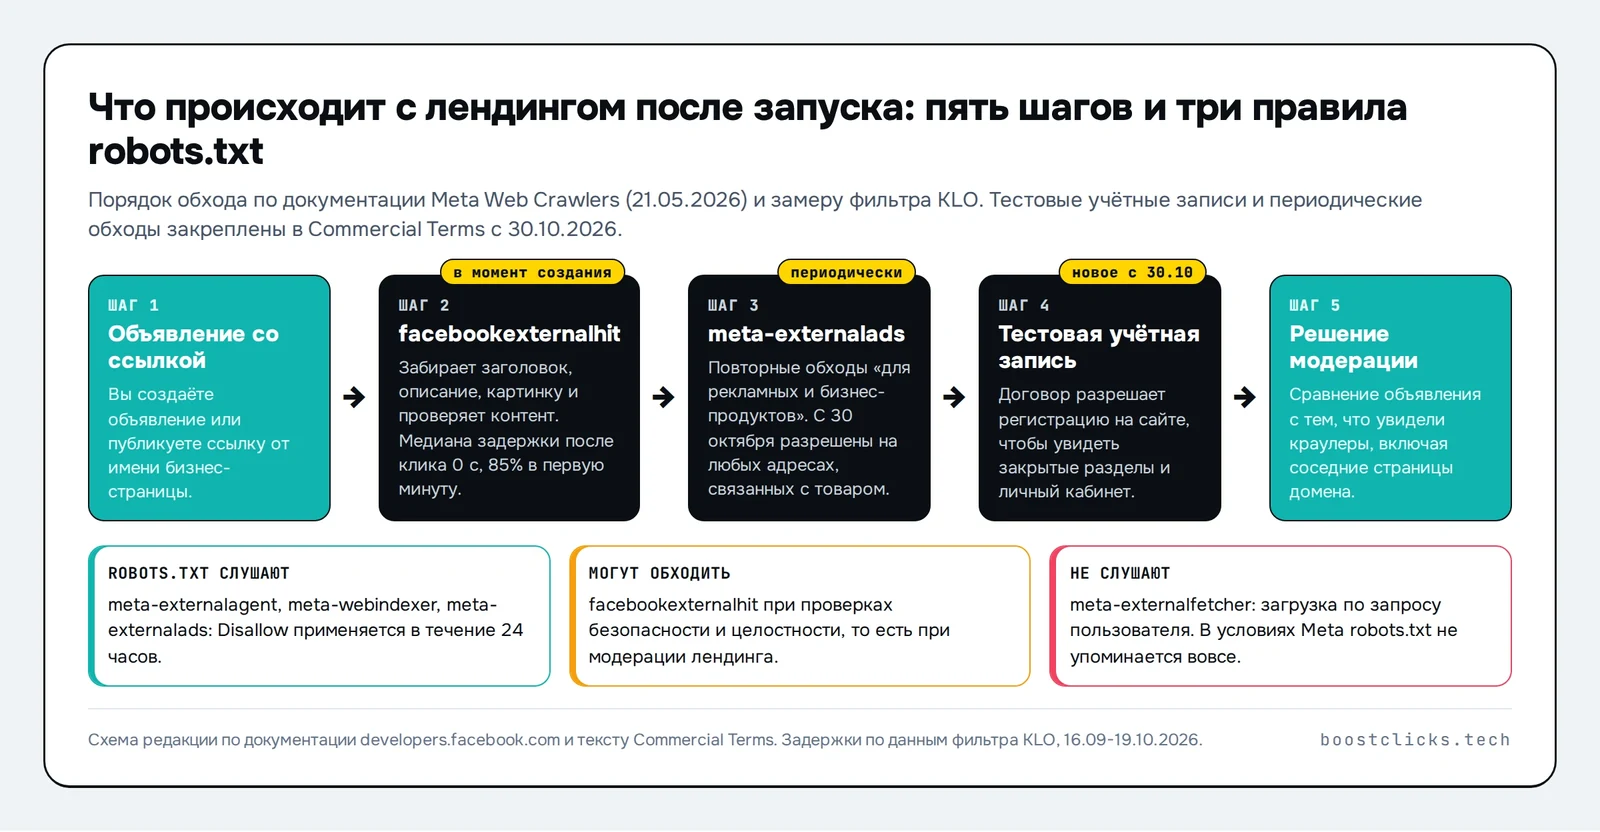
Тот же абзац слово в слово стоит в новой редакции Self-serve Ad Terms. Три формулировки в нём важнее остальных. «Связаны с вашими товарами или услугами»: не «ваш домен», а любой адрес, который Meta сочтёт относящимся к вашему бизнесу. «Создавать тестовые учётные данные»: краулер вправе зарегистрироваться на вашем сайте, чтобы увидеть закрытый раздел. «Периодически забирать обновления»: это не разовая проверка при модерации, а повторные обходы.
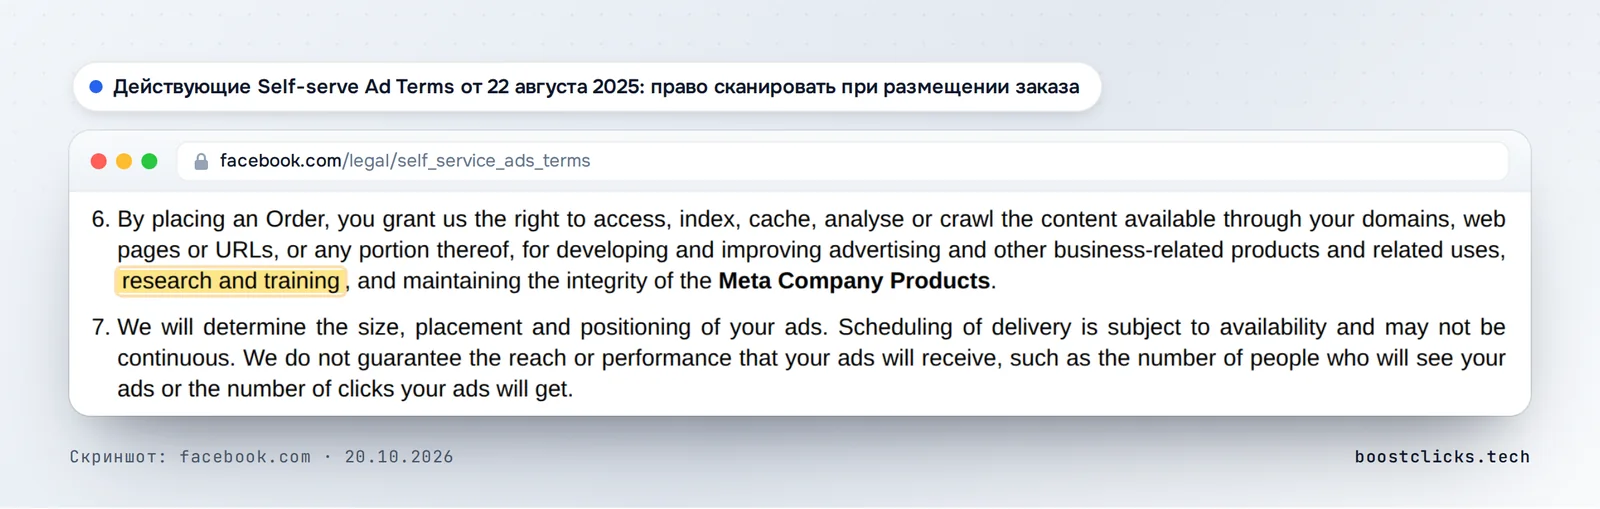
Для сравнения в действующих Self-serve Ad Terms от 22 августа 2025 года разрешение привязано к заказу: «размещая заказ, вы предоставляете нам право получать доступ, индексировать, кешировать, анализировать или сканировать контент, доступный через ваши домены, веб-страницы или URL (…) для разработки и улучшения рекламных и других бизнес-продуктов, исследований и обучения и поддержания целостности». В действующих Commercial Terms от 6 марта 2024 года пункта о сканировании нет вовсе.
| Документ | Редакция | Кто даёт разрешение | Что разрешено |
|---|---|---|---|
| Commercial Terms | 6 марта 2024, действует | никто: пункта нет | нет |
| Self-serve Ad Terms | 22 августа 2025, действует | рекламодатель при размещении заказа | доступ, индексация, кеширование, анализ, сканирование своих доменов; цели включают «исследования и обучение» |
| Ad Creative Generative AI Terms | 6 мая 2024, действует | рекламодатель, который включил ИИ-инструменты для креативов | сканирование URL, которые он сам передал, «для использования в связи с вашей рекламой» |
| Commercial Terms и Self-serve Ad Terms | 30 октября 2026 | любой бизнес-пользователь: реклама, страница, каталог, Business Suite | сканирование адресов, «связанных с товарами или услугами», тестовые учётные записи, периодические обходы; цели: рекламные и бизнес-продукты, целостность и безопасность |
Как формулировка менялась за две недели
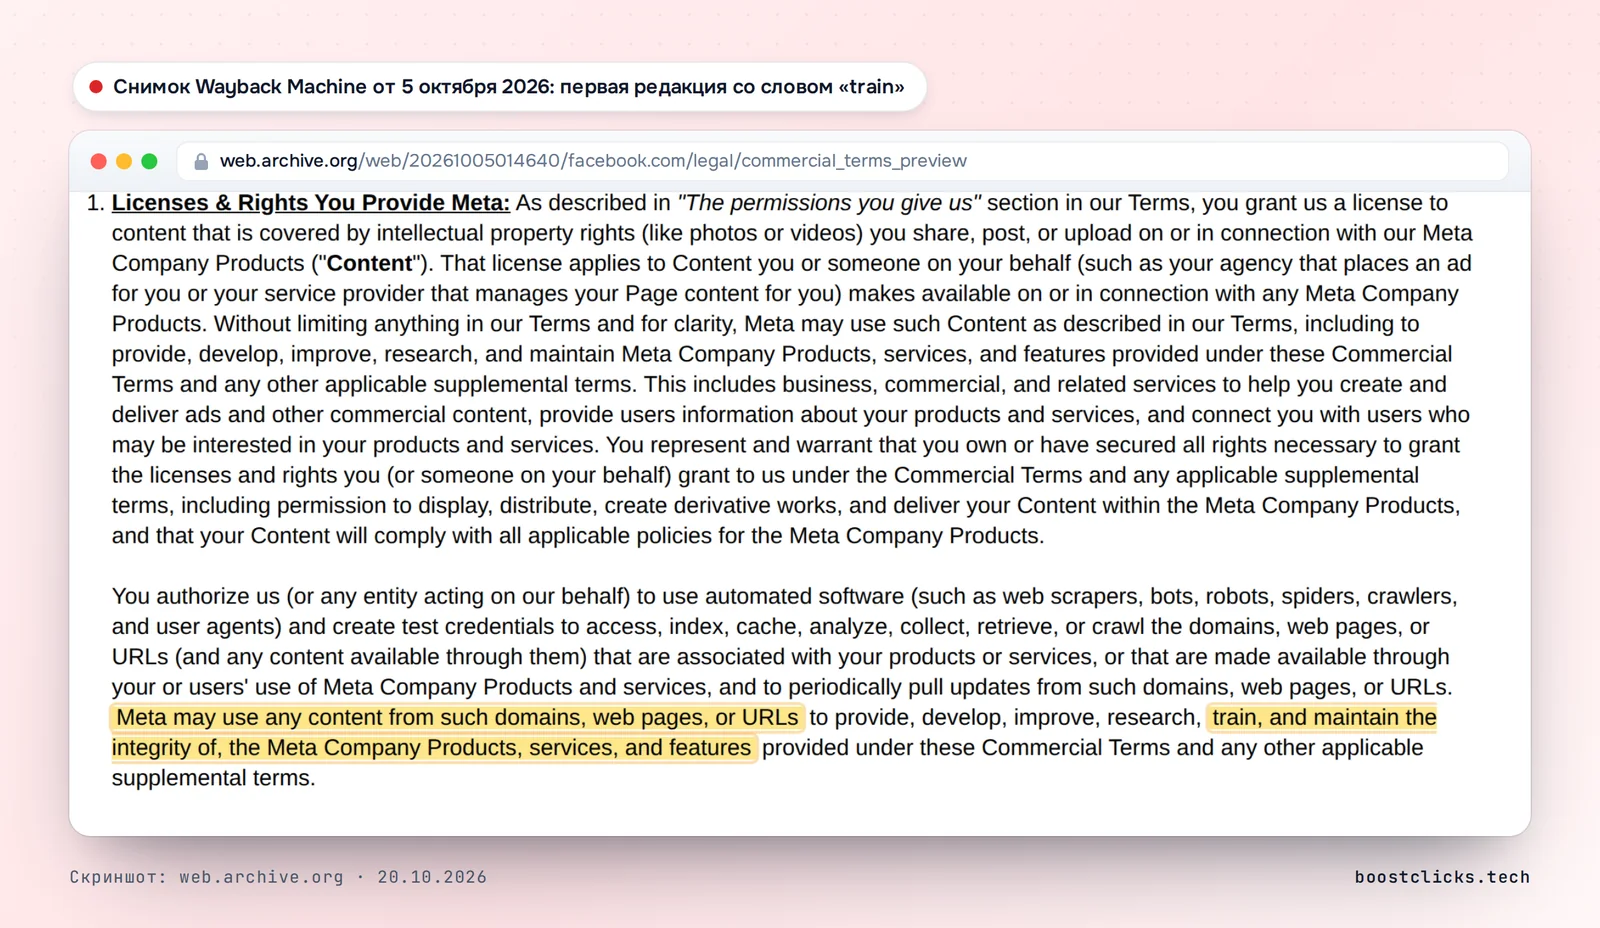
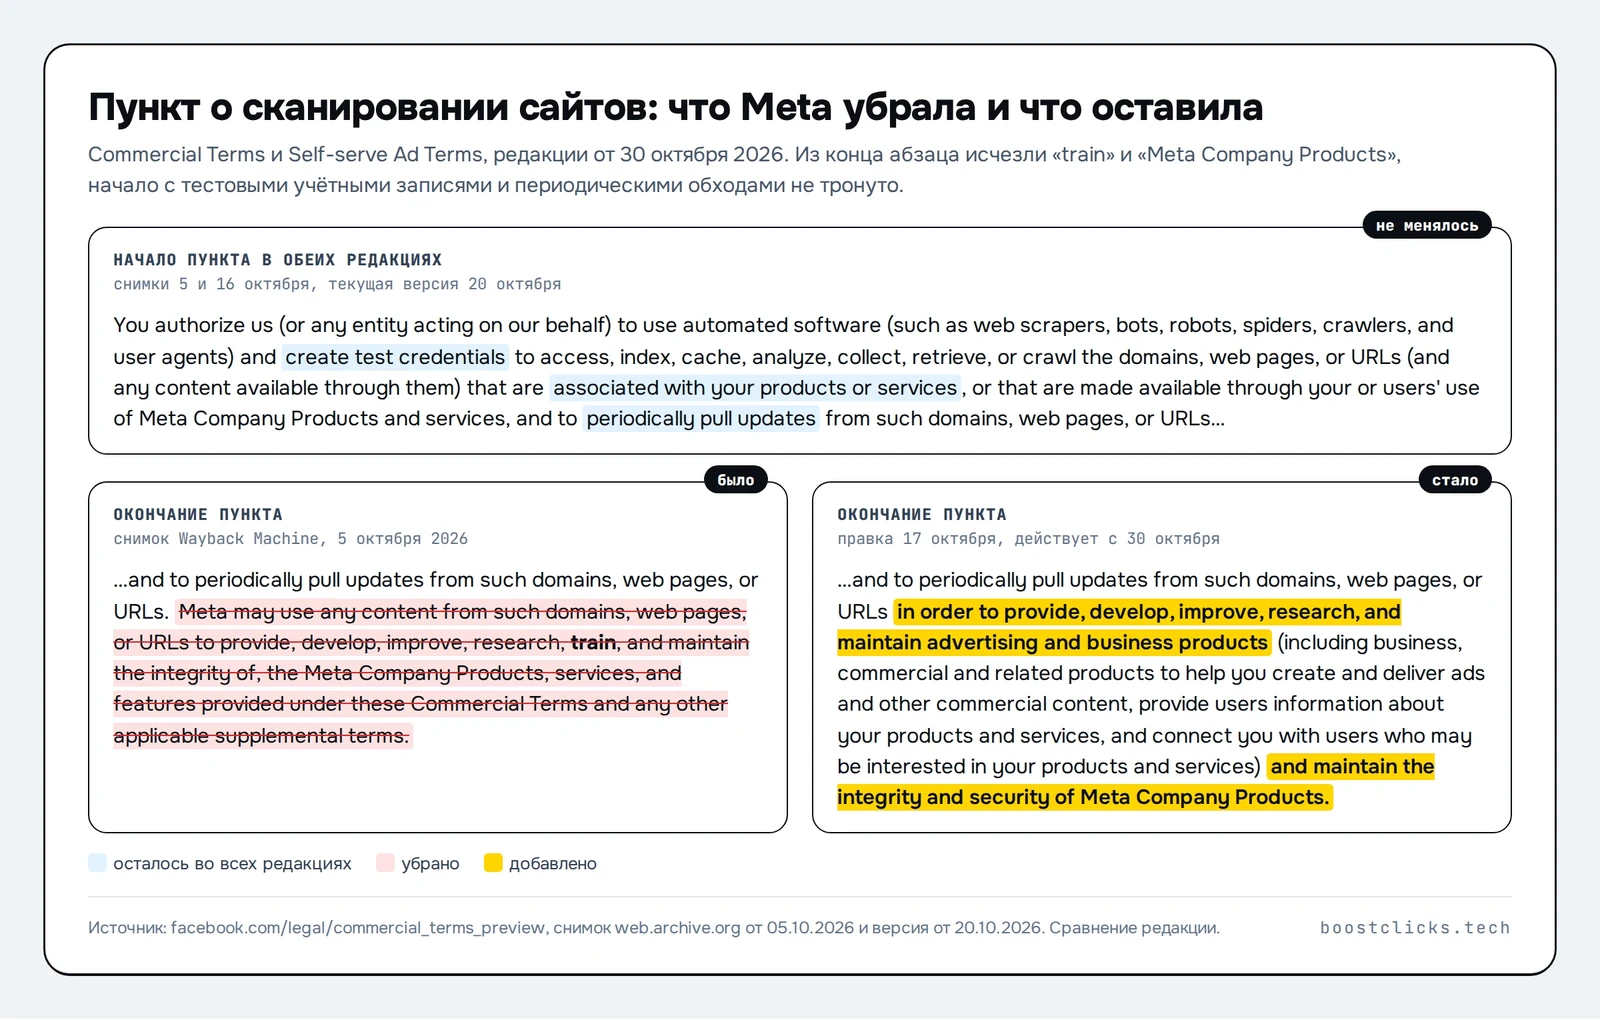
Предварительная версия появилась на сайте Meta в начале октября. В снимке Wayback Machine от 5 октября пункт заканчивался иначе: «Meta может использовать любой контент с таких доменов, веб-страниц или URL, чтобы предоставлять, разрабатывать, улучшать, исследовать, обучать и поддерживать целостность Продуктов компаний Meta, сервисов и функций». Слово «обучать» (train) и широкое «Продукты компаний Meta» вместо «рекламные и бизнес-продукты» и стали причиной скандала.
Хронология по датам:
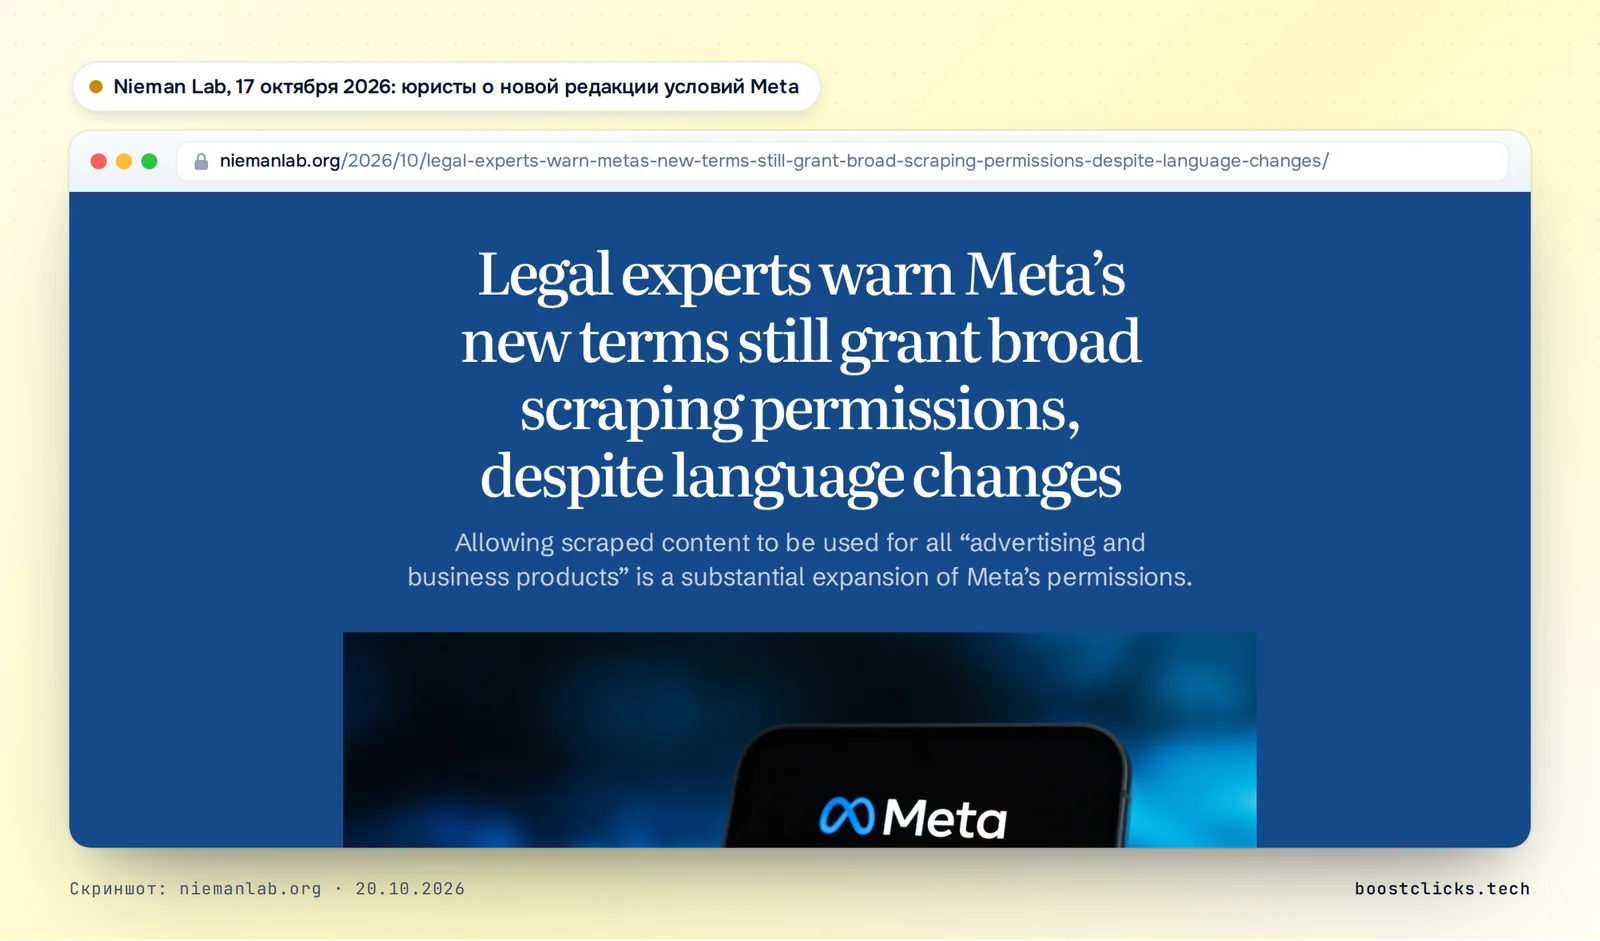
- 15 октября. Nieman Lab публикует разбор с тремя юристами: формулировка позволяет Meta сканировать сайты новостных изданий и использовать контент для обучения ИИ.
- 16 октября. Вице-президент Meta по коммуникациям Энди Стоун отвечает в X, что пересказ ложный, а пункт нужен, чтобы «получать точную информацию о товарах на сторонних сайтах» для рекомендаций. В тот же день Search Engine Journal разбирает, как разрешение расширилось с рекламодателей на все бизнесы, а британская News Media Association называет пункт «захватом земли».
- 17 октября. Meta переписывает абзац: убирает «обучать», сужает цели до «рекламных и бизнес-продуктов». The Verge приводит заявление представителя Meta Дэниела Робертса: «Это не про скрапинг новостных сайтов, и эти обновления не дают нам новых прав поверх предпочтений в robots.txt».
- 17 октября, позже в тот же день. Nieman Lab опрашивает тех же юристов по новой редакции. Профессор Корнеллского университета Джеймс Гриммельман: «разрабатывать рекламные и бизнес-продукты» по-прежнему «достаточно широко, чтобы проехать на грузовике», а оборот «связанные с вашими товарами или услугами» позволяет сканировать сайт целиком.
- 19 октября. SEJ замечает, что британская версия предварительных Self-serve Ad Terms всё ещё содержит старую формулировку с «обучать». Мы проверили 20 октября: в версии
locale=en_GBуже стоит новый текст, идентичный американскому.
Что осталось неизменным во всех редакциях: право создавать тестовые учётные данные, периодические обходы, оборот «связанные с вашими товарами или услугами» и отсутствие упоминания robots.txt. Про robots.txt Meta говорит в комментариях журналистам, а не в договоре.
Кого это касается и можно ли отказаться
Commercial Terms применяются к любому «бизнес-использованию» продуктов Meta. Список в самом документе: реклама и маркетинговые сообщения, продажа и размещение товаров, разработка приложений, каталог товаров, управление страницей, управление группой в деловых целях, Ads Manager и Meta Business Suite, сервисы измерений. Под это определение попадает любой арбитражник с рекламным кабинетом, любой магазин с бизнес-страницей и любое СМИ с аккаунтом в Instagram.
Отказаться, оставшись в системе, нельзя. По словам Nieman Lab, у бизнес-аккаунтов нет опции отклонить новые условия до 30 октября: продолжение использования после этой даты считается согласием, несогласным предлагается прекратить коммерческое использование продуктов. Отдельный абзац Commercial Terms обязывает вас обеспечить соблюдение условий третьими лицами, от имени которых вы работаете: агентство, которое ведёт кабинет клиента, связывает этим пунктом и клиента.
Чем Meta сканирует: пять краулеров из документации
Meta ведёт страницу Meta Web Crawlers (обновлена 21 мая 2026), где перечислены пять user agent и назначение каждого. Сведём её в таблицу и добавим, сколько заходов с каждым UA видел наш фильтр с 16 сентября по 19 октября 2026 года и какая их доля пришла с настоящих адресов Meta (автономная система AS32934). Как считали, ниже.
| User agent | Назначение по документации Meta | robots.txt | Заходов за 34 дня | С IP Meta |
|---|---|---|---|---|
| facebookexternalhit/1.1 | превью ссылок, которыми поделились в Facebook, Instagram, Messenger; проверка контента | соблюдает, но «может обходить при проверках безопасности и целостности» | 1 081 | 98% |
| meta-externalads/1.1 | «улучшение рекламных и других бизнес-продуктов» | соблюдает | 41 | 100% |
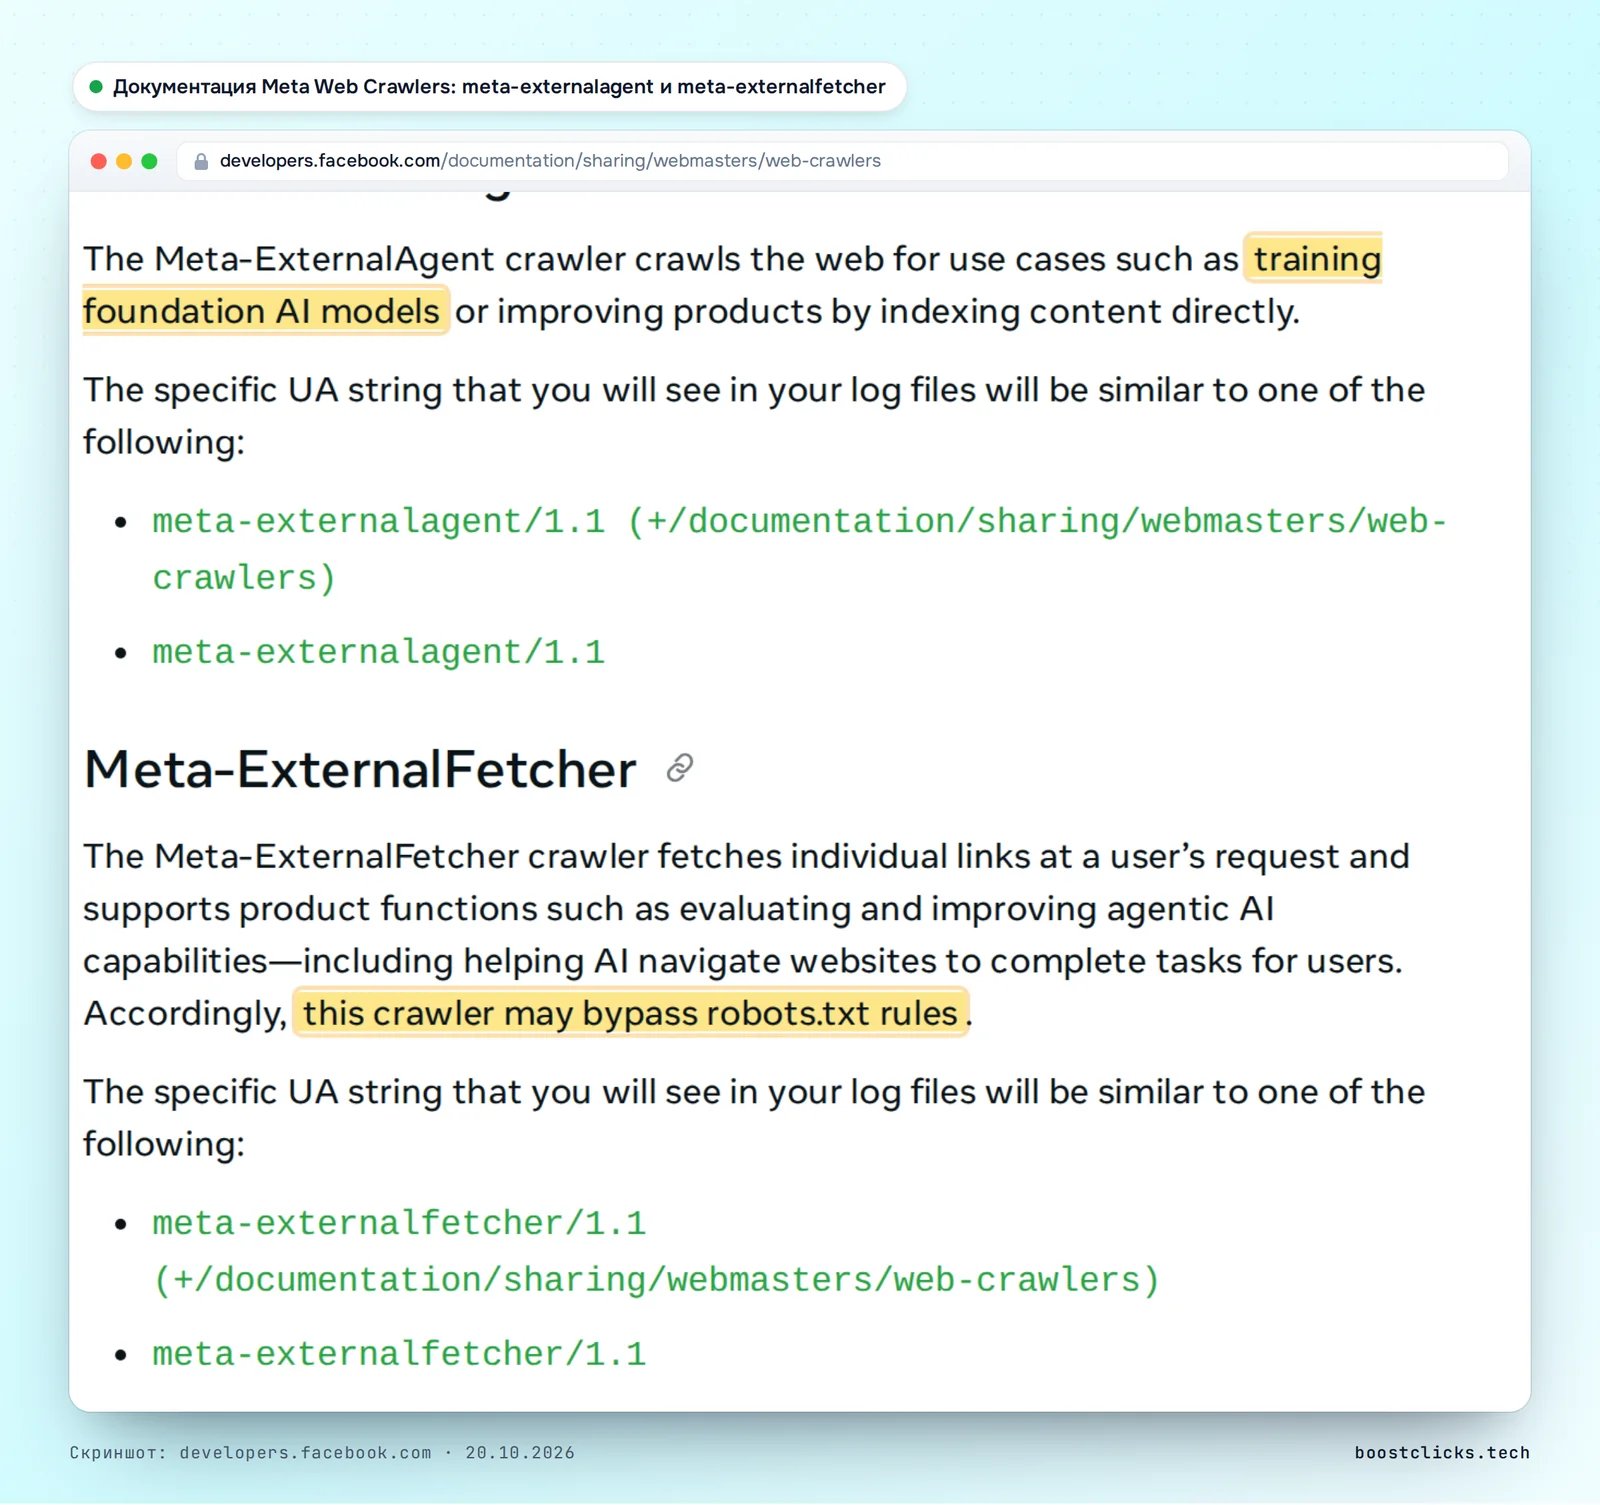
| meta-externalagent/1.1 | обучение фундаментальных ИИ-моделей, индексация контента | соблюдает | 762 | 9% |
| meta-webindexer/1.1 | поиск Meta AI, цитирование и ссылки в ответах | соблюдает | 142 | 60% |
| meta-externalfetcher/1.1 | загрузка ссылок по запросу пользователя, агентные функции ИИ | «может обходить правила robots.txt» | 66 | 0% |
Для рекламы важны два первых. Facebookexternalhit приходит на лендинг в момент создания объявления и при каждом показе превью ссылки, он же делает проверки безопасности. Meta-externalads прямо назван инструментом для рекламных продуктов, и именно он логично ложится под новый пункт про «рекламные и бизнес-продукты». Остальные три про Meta AI: обучение моделей, поиск и агент, который открывает страницы по просьбе пользователя.
Что даёт robots.txt и список IP-адресов
Документация предлагает управлять краулерами через robots.txt и обещает, что изменения применяются в течение 24 часов, потому что файл кешируется. Пример из той же страницы, расширенный на все пять агентов:
User-agent: meta-externalagent
Disallow: /

User-agent: meta-webindexer
Disallow: /

User-agent: meta-externalfetcher
Disallow: /

User-agent: meta-externalads
Allow: /

User-agent: facebookexternalhit
Allow: /
Два исключения записаны там же. Meta-ExternalFetcher «может обходить robots.txt, потому что выполняет загрузки по запросу пользователя». FacebookExternalHit «может обходить robots.txt при проверках безопасности и целостности», то есть при проверке лендинга на вредоносный контент. Для рекламодателя это означает: запретить проверку объявления через robots.txt нельзя, да и не нужно, без facebookexternalhit не появится превью ссылки, а модерация увидит пустую страницу.
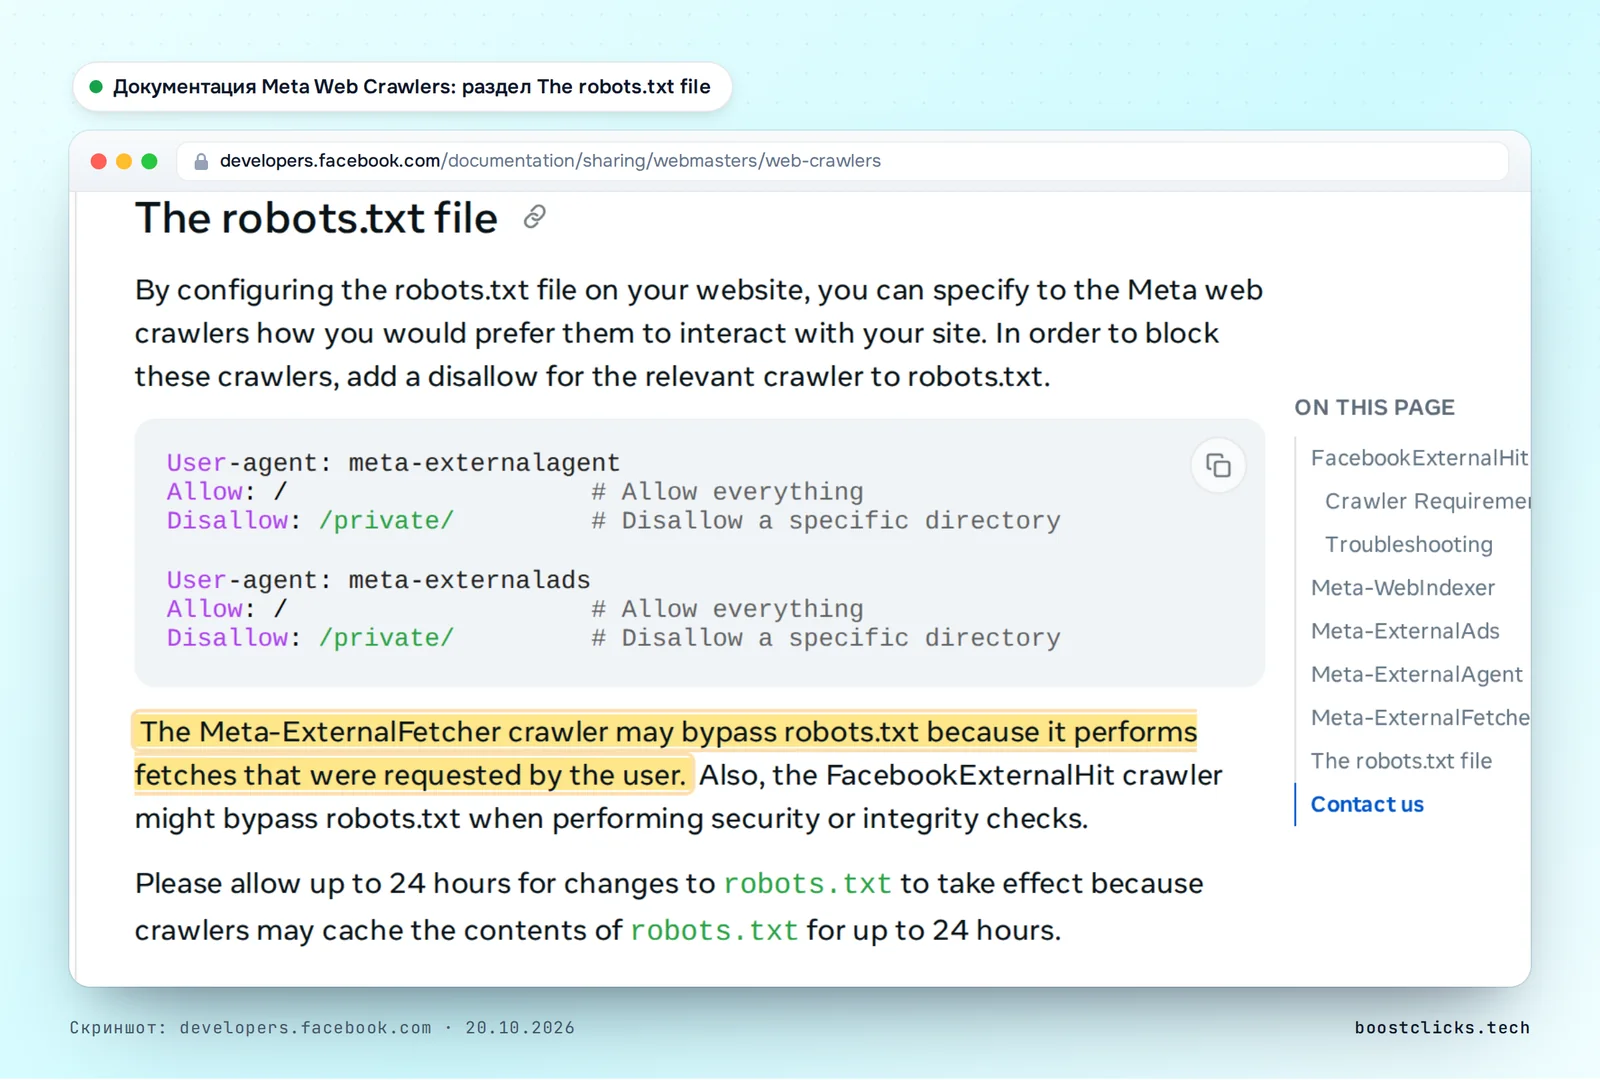
Юридический вес robots.txt описал в комментарии Nieman Lab профессор Университета Висконсина Бенджамин Собел: файл выражает предпочтение владельца, соблюдение которого добровольно, как табличка «не смотрите на мой дом». Нового права он не даёт, а в договоре с Meta его нет.
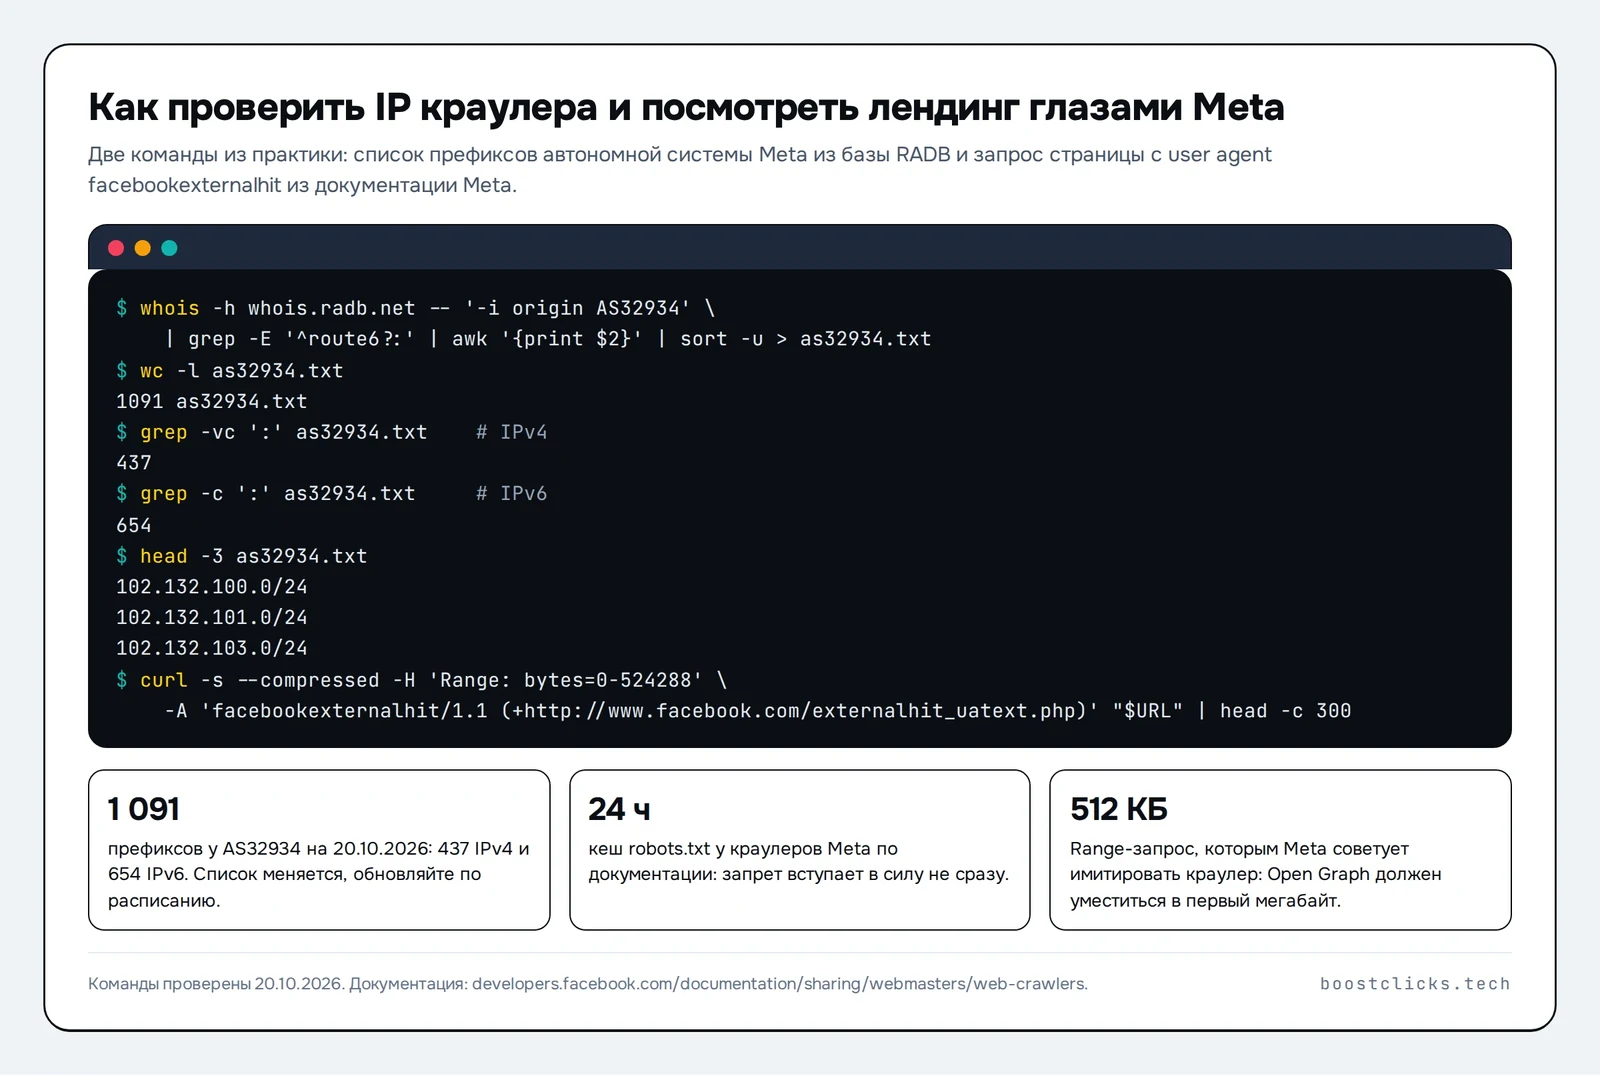
Второй способ, который советует сама документация: вместо строки UA проверять IP-адреса, это «более надёжно». Диапазоны Meta публикует через объекты маршрутизации автономной системы AS32934. На 20 октября 2026 года запрос к базе RADB возвращает 437 префиксов IPv4 и 654 префикса IPv6:
whois -h whois.radb.net -- '-i origin AS32934' | grep -E '^route6?:' | awk '{print $2}' | sort -uСписок меняется, поэтому его нужно обновлять по расписанию, а не вшивать в конфиг один раз. Этот же список использует фильтр при разборе заходов ниже.
Наш замер: кто ходит на лендинги под видом Meta
Фильтр KLO стоит перед лендингами клиентов и пишет каждый заход: IP, user agent, реферер, строку запроса и решение. Мы взяли 34 дня, с 16 сентября по 19 октября 2026 года: 1,65 млн заходов на 237 доменов. Из них 2 092 захода пришли с одним из пяти UA краулеров Meta. Дальше каждый IP сверили со списком префиксов AS32934.
- 1 262 захода (60%) с адресов Meta, 73 домена. 99% из США, остальное Ирландия, Швеция, Дания. На домен в среднем 3 захода за период (медиана), максимум 233.
- 830 заходов (40%) с чужих адресов, в основном из облака Google: сети 34.x и 35.x в США, Бельгии, Тайване, Германии, Японии. Фильтр классифицирует их как хостинг. Это сервисы, которые подписываются краулером Meta: антифрод-чекеры, спай-сервисы, парсеры конкурентов. Самый активный адрес сделал 202 захода на 4 домена.
- Подделка распределяется неравномерно. Facebookexternalhit подделывают редко (17 из 1 081), meta-externalagent почти всегда поддельный (690 из 762), meta-externalfetcher за 34 дня не пришёл с адресов Meta ни разу (66 из 66 с чужих IP). Meta-externalads за период видели только на 2 доменах, оба раза настоящий.
- Скрытых проверок с «человеческим» UA мы не нашли. С адресов AS32934 без краулерной подписи пришло всего 3 захода из 1 265 (0,2%), все три с меткой fbclid и реферером Facebook, то есть это переходы людей через инфраструктуру Meta, а не обход. Meta в наших данных подписывает свои запросы честно.
- Скорость реакции. На 9 доменах, где за период были клики с fbclid, краулер Meta появлялся на каждом. По 39 кликам медианная задержка до ближайшего захода краулера 0 секунд, 85% заходов в пределах минуты. Выборка маленькая, но согласуется с замером в статье про ИИ-пиксель Meta за лето: медиана 97 секунд на 2 678 кликах.
Какие адреса запрашивает краулер: у 1 801 захода из 2 092 строка запроса пуста, то есть открывается корень или путь без меток; с fbclid всего 23 захода. Фильтр во всех 2 092 случаях показал белую страницу по правилу «бот по UA»: UA с подписью Meta уходит в white независимо от IP.
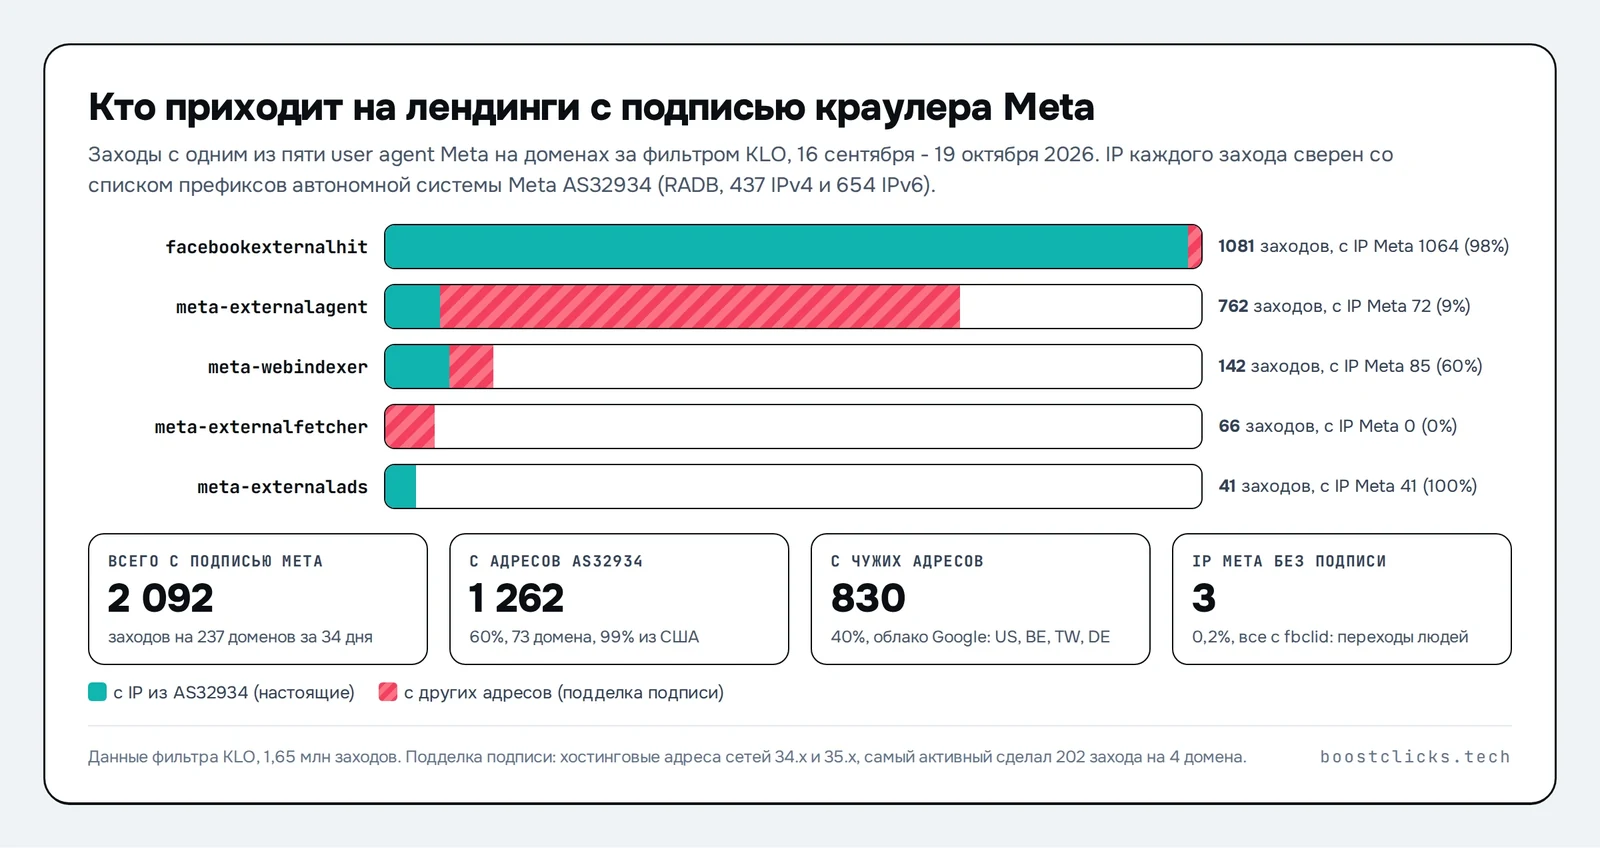
Вывод из замера короткий. Новый пункт договора не добавил Meta технических возможностей, которых у неё не было: facebookexternalhit и meta-externalads ходили на лендинги и до 30 октября, ходят быстро и подписываются. Изменился объём разрешения на бумаге: теперь оно распространяется на всех бизнес-пользователей и на любые адреса, «связанные с товарами или услугами», включая те, куда краулер попадёт через тестовую регистрацию.
Что это значит для арбитражника
Лендинг и прокла должны выдерживать обход целиком. Если раньше проверка касалась страницы, указанной в объявлении, то «связанные с товарами или услугами» адреса включают и соседние страницы домена, и закрытые разделы после регистрации. Несоответствие объявления и страницы перехода описано в разборе про проклу, требования к самому объявлению в таблице по креативам.
Фильтр должен знать Meta в лицо по двум признакам. Правило «подпись Meta в UA, значит белая страница» по нашему замеру остаётся рабочим: за 34 дня Meta ни разу не пришла без подписи. Слабое место в другом: ту же подпись ставят 40% чужих заходов, и все они тоже получают белую страницу. Для модерации это безразлично, а для вас означает, что спай-сервис или чекер конкурента видит ровно то же, что и Meta. Если хотите отдавать им не белую страницу, а заглушку, нужен второй признак: IP из AS32934. Как устроена клоака и какие сигналы в ней работают, разобрано в гайде по клоакингу. Среди сервисов KLO отдаёт белую страницу любому запросу с подписью Meta, держит AS32934 в списке доверенных рекламных сетей и помечает хостинговые адреса с той же подписью как хостинг, так и получен замер выше. В фильтрах Keitaro и Binom похожие правила собираются вручную из условий по UA и спискам IP, список префиксов тогда обновляете сами.
Тестовые учётные записи. Если на домене есть личный кабинет, закрытый каталог или страница «только после регистрации», с 30 октября договор прямо разрешает Meta завести там аккаунт. Контент за регистрацией нужно считать видимым для модерации. Это же относится к схемам, где после авторизации пользователь видит другой оффер.
Проверьте свои сайты так же, как это сделает Meta. Документация даёт готовую команду, которой модераторы имитируют краулер. Запустите её на каждый лендинг и сравните ответ с тем, что видит человек из рекламы:
curl -v --compressed -H "Range: bytes=0-524288" -H "Connection: close" \
  -A "facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)" "$URL"
Чтобы увидеть сайт целиком глазами краулера, включая соседние страницы, удобно скачать его копию с нужным UA и сравнить две версии.
Личные кабинеты и агентские аккаунты. Пункт о третьих лицах обязывает агентство гарантировать согласие клиента. При заливе с личек согласие даёт владелец аккаунта, а сайт, который сканируют, принадлежит вам. Формально разрешение на сканирование выдаёт тот, кто нажимает «продолжить» после 30 октября.
Чек-лист до 30 октября
- Перечитать пункт о сканировании в обоих документах на дату 29 октября: Meta уже меняла текст дважды, может поменять ещё.
- Пройти каждый лендинг и проклу командой curl с UA facebookexternalhit и сравнить с версией для людей.
- Проверить, что на домене нет страниц, которые «связаны с товаром» и противоречат объявлению: старые офферы, тестовые версии, черновики.
- Закрытые разделы считать открытыми: договор разрешает тестовую регистрацию.
- В фильтре проверить два признака: подпись Meta в UA даёт белую страницу, а IP из AS32934 отличает модерацию от спай-сервисов с той же подписью.
- Обновлять список префиксов AS32934 по расписанию, раз в сутки достаточно.
- В robots.txt закрыть meta-externalagent и meta-webindexer, если не хотите кормить Meta AI, и не закрывать facebookexternalhit и meta-externalads.
- Помнить, что meta-externalfetcher robots.txt не читает: защиту от него строить на уровне фильтра.
Частые вопросы
Что такое Commercial Terms Meta простыми словами?
Это договор между Meta и любым, кто пользуется её продуктами в деловых целях: запускает рекламу, ведёт страницу компании, загружает каталог, работает в Business Suite. Он дополняет пользовательские условия Facebook и Instagram. Новая редакция вступает в силу 30 октября 2026 года.
Правда ли, что Meta сможет сканировать весь мой сайт?
Текст разрешает сканировать «домены, веб-страницы или URL, связанные с вашими товарами или услугами», создавать тестовые учётные записи и периодически забирать обновления. Юристы, которых опросил Nieman Lab, считают, что этого достаточно для обхода сайта целиком. Технически Meta делала это и раньше через facebookexternalhit, но разрешение было привязано к рекламному заказу.
Поможет ли robots.txt?
Частично. Meta-externalagent, meta-webindexer и meta-externalads по документации его соблюдают, meta-externalfetcher может игнорировать, facebookexternalhit может игнорировать при проверках безопасности. В самих условиях robots.txt не упоминается, поэтому это просьба, а не запрет.
Как отличить настоящий краулер Meta от подделки?
По IP-адресу. Настоящие запросы приходят из сетей автономной системы AS32934, список префиксов есть в базе RADB. По нашему замеру за 34 дня 40% заходов с подписью Meta в UA пришли из облака Google, то есть от сторонних сервисов.
Можно ли не принимать новые условия?
Единственный вариант по тексту Meta: прекратить использовать продукты в коммерческих целях до 30 октября. Продолжение работы после этой даты считается согласием. Отдельной галочки «не согласен» для бизнес-аккаунтов нет.
Что в итоге
С 30 октября 2026 года разрешение на сканирование сайтов переезжает из рекламного заказа в общие условия для бизнеса и получает три новых детали: любые адреса, «связанные с товарами или услугами», тестовые учётные записи и регулярные обходы. Слово «обучать» Meta убрала после недели критики, остальное оставила. По нашему замеру краулеры Meta подписываются честно и приходят на лендинг в первую минуту после клика, а 40% заходов с их подписью делают вовсе не Meta. Практический вывод для арбитража: лендинг и прокла должны выдерживать обход целиком, включая разделы за регистрацией, а фильтр должен различать Meta по IP, а не по строке user agent.